NVIDIA, full-stack codesign ile AI fabrikalarında bellek baskısını azaltmayı hedefliyor
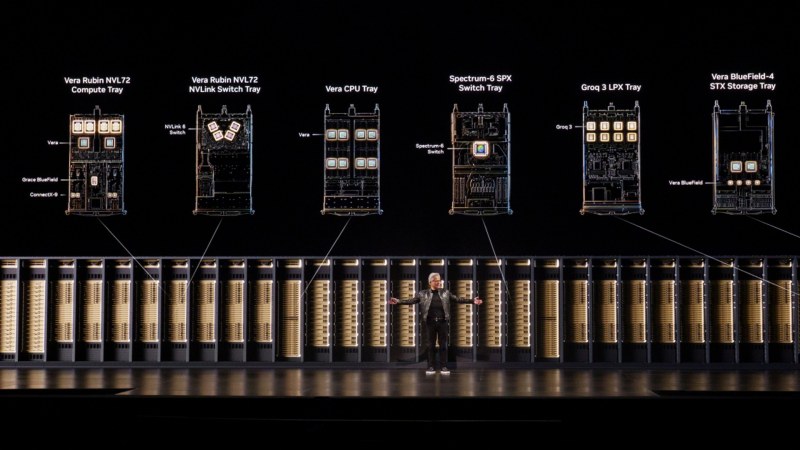
NVIDIA, GPU, CPU, ağ, depolama ve yazılımı birlikte tasarlayarak AI factory'nin her katmanında bellekten daha fazla faydalı iş çıkarmayı amaçlıyor. Şirket, Vera Rubin NVL72'nin GB300 NVL72'ye kıyasla dolar başına 30 kata kadar daha yüksek işlem hacmi sunduğunu iddia ediyor.
Bellek baskısı artıyor
NVIDIA Blog'a göre daha büyük modeller, daha uzun bağlamlar ve agentic uygulamalar GPU bellek baskısını artırıyor. Aynı dönemde bellek arzının daraldığı ve fiyatların yükseldiği, bu eğilimin yakın vadede sürmesinin beklendiği belirtiliyor.
Öncü modeller trilyonlarca parametreye sahip. KV cache, modelin her aktif isteği aynı bilgiyi yeniden işlemeden anlaması için gereken bağlamı tutuyor. Agentic yörüngeler bazı durumlarda 3 milyon token'a kadar işlem yapabiliyor. RAG ise ilgili kurumsal bilgiyi istemlere ekleyerek işlenecek ve tutulacak bağlamı daha da artırıyor. Çıkarım sırasında HBM öncelikle hem model parametrelerini hem de KV cache'i tutuyor.
Hiyerarşi ve memory wall
GPU HBM, AI factory bellek hiyerarşisinde en hızlı, en pahalı ve en çok rekabet edilen katman olarak tanımlanıyor. Bu katmanda model ağırlıkları ve KV cache sınırlı kapasite için rekabet ediyor. HBM'in altında CPU belleği, yerel SSD'ler ve paylaşımlı depolama katmanları yer alıyor; her biri hız karşılığında daha fazla kapasite ve daha düşük bit başına maliyet sunuyor.
Bellek bant genişliği, hesaplamanın veriyi kullanabildiği hıza yetişemediğinde oluşan sınıra memory wall deniliyor. NVIDIA'nın yaklaşımı GPU'ya daha fazla bellek yığmak değil, full-stack codesign uygulamak. NVIDIA, AI factory'nin her katmanında bellekten daha fazla faydalı iş çıkarmak için GPU, CPU, ağ, depolama ve yazılımı birlikte tasarlıyor.
Ağırlıkları ve KV cache'i küçültme
NVFP4 formatı, Hopper platformunda mümkün olan en düşük hassasiyet olan FP8'e kıyasla ağırlıklar için gereken alanı azaltıyor. FLUX.2 [klein], Inkling, Beam 1.0, Meta Muse Spark, Step 5 Preview ve NVIDIA Nemotron 3.5 Super VL modelleri NVFP4 checkpoint'leriyle yayımlanmış durumda. NVL72 sistemi içinde model ağırlıkları 72 GPU'ya kadar dağıtılabiliyor.
KV cache'e NVFP4 uygulanması, FP8'e kıyasla kapladığı alanı azaltıyor. NVIDIA Vera CPU, büyük LPDDR belleğini NVIDIA NVLink-C2C ara bağlantısı üzerinden NVIDIA Rubin GPU'larına bağlıyor. Bağlam aktif kullanımda değilken NVIDIA Dynamo çıkarım yazılımı onu NVIDIA CMX context memory storage'a taşıyor ve yeniden kullanımdan önce geri getiriyor. CMX, yerel SSD'lerden farklı olarak sunucular arasında paylaşılıyor.
Dynamo'nun KV Cache Reuse özelliği KV cache'i GPU belleği, CPU belleği ve depolama genelinde sistem çapında tek bir kaynak olarak yönetiyor. NVIDIA Nemotron Retriever modelleri daha küçük embedding'ler üretiyor; NVIDIA cuVS kütüphanesi ise arama indeksinin CPU ve depolama genelinde oluşturulup sunulmasını sağlıyor.
Nesil başına dolar başına daha fazla çıktı
NVIDIA Blog'a göre Blackwell Ultra'dan Vera Rubin platformuna GPU başına HBM kapasitesi yaklaşık %3 arttı. Aynı kaynakta semiAnalysis AgentX üzerinde agentic işlem hacminin dolar başına 30 kata kadar arttığı iddia ediliyor.
semiAnalysis AgentX DeepSeek V4 Pro iş yükünde NVIDIA GB300 NVL72, kullanıcı başına 100 token/saniye hızında NVIDIA H200 platformuna kıyasla dolar başına 10 kata kadar daha yüksek işlem hacmi sunuyor. Kullanıcı başına 125 token/saniye hızında ise Vera Rubin NVL72, GB300 NVL72'ye kıyasla dolar başına 30 kata kadar daha yüksek işlem hacmi sunuyor.
NVIDIA Blog, NVIDIA'nın her katmanda bellekten bit başına en verimli kullanımı sağladığını ve full-stack codesign'in bellekten her byte'ın sağladığı faydalı işi artırarak token maliyetlerini düşürdüğünü iddia ediyor. NVIDIA, bellek ortaklarıyla yakın çalışarak en yeni bellek teknolojilerini hızla benimsiyor; şirket HBM3e ve HBM4 teknolojilerini hızlandırılmış bilişim yığınına ilk benimseyen şirket olarak belirtiliyor.