Hcompany, 260M ve 800M Parametreli NeoMME-Retriever Modellerini Tanıttı
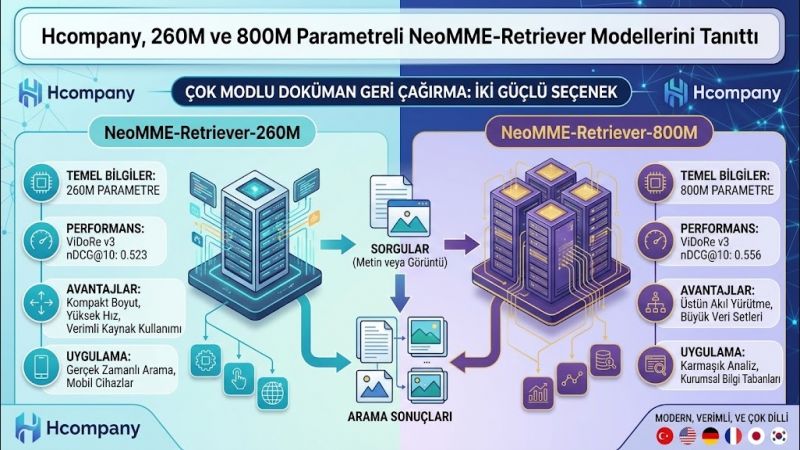
Hcompany tarafından geliştirilen NeoMME-Retriever-260M, ViDoRe v3 üzerinde 0.523 nDCG@10 skoruna ulaşarak 800M altındaki modeller arasında en yüksek performansı gösterdi. 800M versiyonu ise 0.556 skor elde etti. Tek Transformer mimarisiyle hem metin hem görüntü işleyen modeller, late-interaction ve dense embedding'leri tek seferde üretirken yüksek çözünürlüklü indeksleme için 255 kat depolama optimizasyonu sunuyor.
Hcompany, Hugging Face üzerinden NeoMME adlı 260M ve 800M parametre boyutlarında multimodal-native ve multilingual encoder ailesini tanıttı. NeoMME-Retriever-260M, ViDoRe v3 benchmark'ında 0.523 nDCG@10 skoruna ulaşarak 800M altındaki modeller arasında en yüksek performansı kaydetti. NeoMME-Retriever-800M ise 0.556 nDCG@10 skoruna ulaştı. Her iki model de ViDoRe v3 Pareto frontier'ında yer alıyor.
NeoMME, ayrı bir pretrained vision tower veya causal language model kullanmadan tek bir bidirectional Transformer ile hem metin token'larını hem de raw görüntü patch'lerini işliyor. Model, 32×32'lik non-overlapping görüntü patch'lerini MLP ile projekte ediyor ve dynamic image resolution ile aspect ratio'yu koruyarak yüksek çözünürlüklü belgelerde daha fazla token kullanıyor. Bağlam uzunluğu 16.384 token olup iki adet 4K görüntüye yetecek kapasite sunuyor.
NeoMME Mimari ve Pretraining Detayları
Model, grouped-query attention, query-key normalization, gated attention, 2D rotary position embeddings ve squared-ReLU MLP'ler gibi modern encoder tekniklerini kullanıyor. Multilingual BPE tokenizer 131 bin vocab büyüklüğünde ve metin, kod, matematik ile makine üretilmiş görüntü transkriptleri üzerine eğitildi. Pretraining discrete masked-diffusion objective ile yapıldı; metin token'ları %0-100 arası oranda maskelenirken görüntü patch'leri görünür kalıyor. Toplam 524 milyar token işlendi, bunun 290 milyarı text-only örneklerden oluştu. NorMuon optimizer veri verimliliğini artırdı.
NeoMME-Retriever Performansı ve Karşılaştırmalar
NeoMME-Retriever, ColPali'nin page-image yaklaşımıyla fine-tune edildi ve OCR ihtiyacını ortadan kaldırarak belge sayfası görüntülerini doğrudan sıralıyor. Tek forward pass'ta hem dense (mean pooling) hem de late-interaction (128 boyutlu patch/token vektörleri) embedding'leri üretiyor. NeoMME-Retriever-260M, ColQwen2.5-v0.2'nin (3.75B parametre) 0.524 skoruna çok yakın 0.523 elde ederken yaklaşık 14 kat daha az parametre kullandı. 800M versiyonu ise ColPali v1.3'ten daha iyi performans gösterirken 3.6 kat daha az parametreye sahip.
ViDoRe v3 sonuçlarına göre 260M model ColModernVBERT ve iki katı büyüklükteki ColSmol-500M'den daha iyi skorlar aldı. 800M model de benzer boyutlu Vultron Retriever Flash'e yakın performans gösterdi.
Yüksek Çözünürlükte Depolama Optimizasyonu ve Hız
Late-interaction embedding'leri 2048×2048 görüntülerde ortalama 1.5 MB yer kaplıyor. Hierarchical token pooling ve asymmetric quantization ile bu boyut 6 kB'a (255 kat küçülme) indirildi; baseline nDCG@10 skorunun %95'inden fazlası korundu. Bir diğer konfigürasyonda 39 kB ile %99'dan fazla kalite korunabildi.
NVIDIA L40S GPU'da 2048×2048 çözünürlükte NeoMME-Retriever-260M saniyede yaklaşık 51 sayfa kodluyor. Bu, ColModernVBERT'in 26 sayfa/saniyesinin yaklaşık iki katı. Daha küçük çözünürlüklerde de her iki NeoMME-Retriever modeli rakiplerinden daha hızlı.
Modeller Apache 2.0 lisansı altında Hugging Face Transformers'ta yayınlandı. Dense ve late-interaction checkpoint'leri Sentence Transformers v6 ile fine-tuning için de hazır. Visual RAG demo'su da kullanıcıların test etmesi için sunuldu.