LiquidAI, LFM2.5-VL-3B için deneysel DSpark draft modelini yayımladı
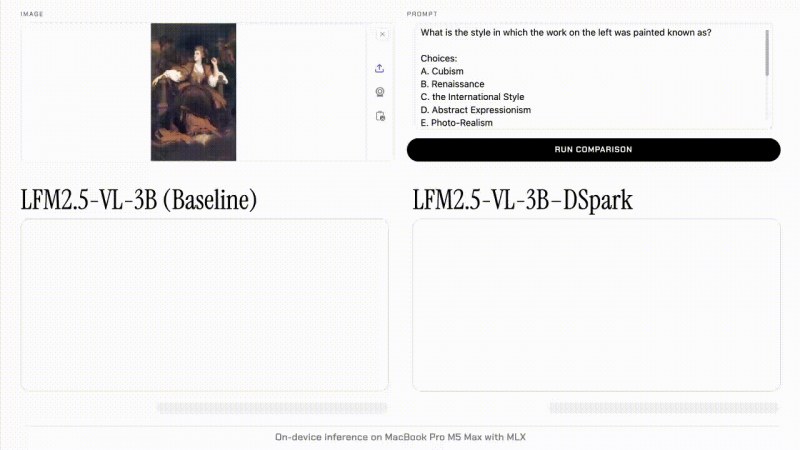
LiquidAI, görüntü-dil modeli LFM2.5-VL-3B için deneysel bir DSpark draft modeli yayımladı. Model, cihaz üzerinde kod çözmede 3.13 kata, H100'de 2.66 kata kadar hızlanma sağlıyor; drafter hedef modele 280M parametre ekleyerek parametre sayısını yalnızca %8,9 artırıyor.
LiquidAI'dan deneysel DSpark draft modeli
LiquidAI, görüntü-dil modeli LFM2.5-VL-3B için deneysel bir DSpark draft modeli yayımladı. Şirketin daha önce çıkardığı LFM2.5-DSpark drafter modellerinde olduğu gibi bu sürüm de bir speculative decoding yolu ekliyor. Bu yol, çıktı kalitesini değiştirmeden bellek ayak izinde minimal bir artış karşılığında daha büyük bir hızlanma sağlıyor. Blog yazısı 24 Eylül 2026 tarihinde yayımlanmış ve 19 beğeni almıştır.
Hızlanma ve bellek maliyeti
LiquidAI'ya göre cihaz üzerinde kod çözme hızlanması 3.13 kata kadar çıkıyor. H100 üzerinde kod çözme hızlanması 2.66 kata kadar olurken uçtan uca kazanım 2.62 kata kadar çıkıyor. Aynı kaynağa göre H100 üzerinde uçtan uca kazanım 2.27 kata kadar ulaşıyor.
Drafter, hedef modele 280M parametre ekliyor. LiquidAI'ya göre bu, 3B hedef modelin üzerine %8,9 ek yük getiriyor. Ortaya çıkan drafter yaklaşık 280M parametreye sahip ve dağıtılan modelin parametre sayısını yalnızca %8,9 artırıyor.
Parametre dağılımı şu şekilde: 4 katmanlı decoder stack 193.0M, hidden-state projection 21.0M, Markov head 65.5M ve norms + confidence head 6.4k. Toplam parametre sayısı 279.5M.
Mimari ve eğitim
Vision drafter, metin LFM2.5-DSpark drafterlarıyla aynı mimariyi kullanıyor. Drafter, hedef modelin gizli durumlarını sabit bir dizi seçilmiş katmanda yakalıyor ve bunlara koşullanarak k aday tokenlık bir blok taslaklıyor. Görüntü yamaları ve metin tokenları bu katmanlardan önce paylaşılan bir temsile yansıtılıyor. Böylece drafter, girdi modalitesinden bağımsız olarak aynı boyutluluktaki gizli durum vektörleri üzerinde çalışıyor ve çıkarım algoritması metin modellerinden değişmiyor.
Eğitim, beklenen iş yüklerine ağırlık verilen bir görüntü-dil SFT verisi karışımıyla DSpark tarifini izliyor. 3, 4 ve 5 katman üzerinde yapılan ablasyonlara dayanarak draft model, 4 katmanlı ve blok boyutu 9 olan basitleştirilmiş bir dikkat-only drafter olarak belirlendi. Nihai karışım üzerinde 10 epoch çalıştırıldı. Kabul oranı her epoch sonrası ölçüldü ve ek eğitim tokenlarıyla azalan getiri noktasına ulaşana dek iyileşti. Çıkarım zamanında donanıma bağlı olarak blok boyutu 8 veya 9 öneriliyor.
CPU ve GPU üzerinde ölçümler
LFM2.5-VL-3B için DSpark draft modeli, llama.cpp, MLX-VLM ve SGLang için ilk günden desteğiyle geliyor. Hem cihaz üzeri çıkarım hem de GPU çıkarımı ölçüldü. Her iki yapılandırma da DSpark blok boyutu 8 kullanıyor.
Değerlendirme; genel VQA, metin VQA, görüntü altyazılama, grafik VQA, karmaşık akıl yürütme ve çok turlu konuşma dahil altı çeşitli görüntü tabanlı görevde yapıldı ve MMSpec benchmark'ını takip ediyor.
Cihaz üzerinde M5 Max'te MLX ile kod çözme göreve göre 2.30x ile 3.13x arasında daha hızlı çalışıyor; uçtan uca gecikme 1.56x ile 2.62x arasında iyileşiyor. M3 Ultra'da llama.cpp ile kod çözme 1.57x ile 2.14x, uçtan uca ise 1.30x ile 1.77x arasında iyileşiyor.
GPU tarafında H100'de aynı drafter 20.4x ile 2.66x arasında daha hızlı kod çözme sağlıyor; uçtan uca iyileşmeler 1.64x ile 2.27x arasında.
Görüntü iş yüklerinde spekülasyonun sınırları
LLM'lerde prefill çoğunlukla hesaplama sınırlıdır ve maliyeti istem uzunluğuyla (alt)karesel olarak büyür. VLM'lerde görüntü önce bir vision encoder'dan geçer, ardından dil omurgası metin istemiyle birlikte yüzlerce görsel tokenı işler. Uç cihazlar veri merkezi GPU'larından çok daha az hesaplama gücüne sahip olduğu için prefill, uçtan uca gecikmenin daha büyük kısmını kaplar. M5'in çekirdek başına GPU sinir hızlandırıcıları bu boşluğu daraltıyor.
Speculative decoding yalnızca kod çözmeyi hızlandırır; görüntü kodlamayı veya prefill'i hızlandırmaz. Bu aşamalar duvar süresinin çoğunu zaten kapladığında, büyük bir kod çözme hızlanması bile yalnızca mütevazı bir uçtan uca kazanç sağlar. Bu, genel hızlanmanın hızlandırılmayan iş yükü kısmıyla sınırlandığı Amdahl yasasıdır.
Kullanım ve erişilebilirlik
DSpark draft modellerini SGLang ile çalıştırmak, LFM2 hedefleri için DSpark desteği içeren bir SGLang derlemesi gerektiriyor. Blok boyutu draft'ın config.json dosyasından okunuyor. llama.cpp ile çalıştırmak ilgili llama.cpp derlemesini, MLX-VLM ile çalıştırmak ise ilgili derlemeyi gerektiriyor; blok boyutu sidecar metadatasından okunuyor.
Speculative decoding kesindir; hedef önerilen her tokenı doğrular, dolayısıyla greedy çıktı tek başına hedefle aynıdır. Yanıt başına zamanlamalar draft_n / draft_n_accepted bildirir.
Vision DSpark draft modeli Hugging Face'te Safetensors ve GGUF formatlarında mevcut. LiquidAI'ya göre LFM2.5 ile her yerde çalışan AI vizyonlarını gerçekleştiriyorlar; bu modeller açık ağırlıklı olup kısıtlama olmadan indirilebilir, ince ayar yapılabilir ve dağıtılabilir. Kaynağa göre modeller ilk günden hızlı ve llama.cpp, MLX ve SGLang için ilk günden desteğe sahip. LiquidAI bu aileyi eksiksiz olarak tanımlıyor: özelleştirme için temel modellerden özel ses ve görüntü varyantlarına kadar tek bir mimari çeşitli kullanım durumlarını kapsıyor.
LiquidAI/LFM2.5-VL-3B modeli 3B, LiquidAI/LFM2.5-VL-3B-DSpark modeli ise 0.3B parametreye sahip.